Jev en e-commerce : 4 décisions à automatiser, et 3 à éviter
Jev ne rédige rien : il répond par une catégorie, une note ou une probabilité. Les décisions d'une boutique qu'il traite, et celles qu'il rate.
L'essentiel
- Le temps que ça prend aujourd'hui : chaque message, chaque avis et chaque fiche fournisseur passe par quelqu'un qui lit d'abord, puis classe, puis agit.
- Ce qu'on automatise vraiment : le tri, jamais la réponse. Le modèle rend une catégorie, une note ou une probabilité, et rien d'autre.
- Ce qui reste humain : les seuils de déclenchement, les cas litigieux et toute décision qui coûte de l'argent au client.
Jev est un modèle sorti le 15 septembre 2026 qui ne rédige rien. On lui envoie un texte et une question fermée, il renvoie une réponse typée avec sa probabilité. Pour une boutique, ça déplace une seule chose, et c’est la bonne : le moment où une personne doit lire avant de décider.
À quoi ressemble le problème
Lundi matin, la boîte du service client contient trente messages. Une personne les ouvre un par un. Celui-ci demande où en est un colis, celui-là veut renvoyer une paire de chaussures, le troisième est en colère.
Aucun de ces messages n’a encore reçu de réponse. Le travail qui vient de se faire, c’est du tri, et il a mobilisé quelqu’un qui sait répondre.
Le soir, la même personne recommence. Entre les deux, elle a été coupée par un fournisseur, par une commande à préparer et par une question d’un collègue. Chaque reprise coûte quelques minutes que personne ne compte.
Le même geste se répète ailleurs dans la journée :
- Un avis arrive sur une fiche produit. Quelqu’un le relit avant publication.
- Un fournisseur envoie un catalogue. Quelqu’un range chaque référence dans la bonne famille.
- Une commande semble bizarre. Quelqu’un regarde l’adresse avant de lancer l’expédition.
Dans les quatre cas, la décision finale demande un cerveau humain. Mais la phase qui la précède est une question fermée à réponse courte : dans quelle catégorie ça tombe, est-ce que c’est urgent, est-ce que ça mérite un contrôle.
Cette phase-là encombre la journée sans rien produire de visible pour le client. Elle est aussi la plus facile à décrire : une liste de cas possibles, et une règle pour choisir.
Ce que Jev sait faire, et ce qu’il ne sait pas
Jev n’accepte que trois formes de question, et c’est cette contrainte qui fait tout l’intérêt. Une Choice sélectionne une option dans une liste fermée, jusqu’à 255. Une Score note sur une échelle de 2 à 10 niveaux. Une Noul renvoie la probabilité qu’une affirmation soit vraie.
La réponse ne peut pas sortir de la liste fournie. Elle arrive avec sa distribution de probabilités et, pour Choice et Score, un indice de confiance entre 0 et 1. Un logiciel peut agir dessus sans relire du texte libre ni nettoyer un format.
L’éditeur annonce une latence de 70 à 500 millisecondes et un prix d’entrée de 0,042 dollar par million de jetons, les jetons de sortie étant offerts. Les comparaisons de vitesse publiées dans l’annonce de TypeSafe du 15 septembre 2026 sont mesurées par l’éditeur lui-même, sur ses propres cas.
Ces valeurs viennent de la page officielle des modèles, relevée le 21 septembre 2026.
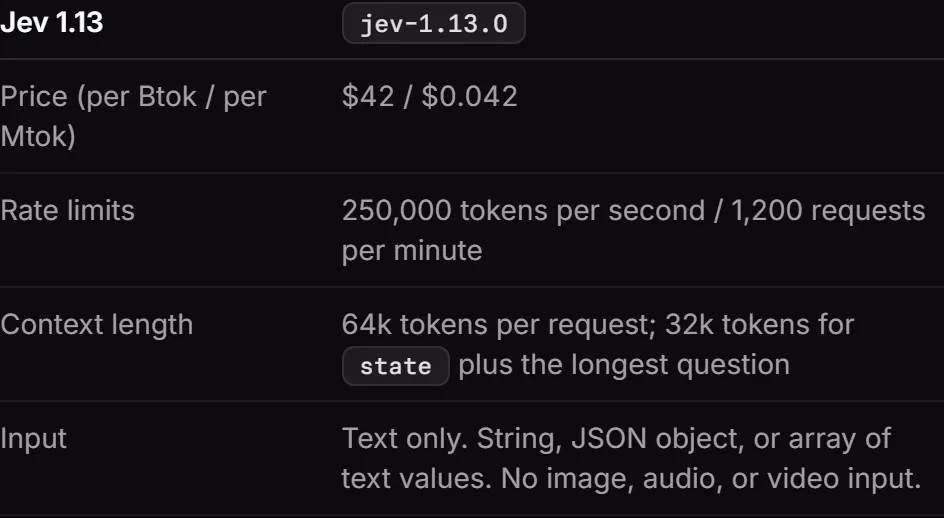
Les limites, elles, sont écrites noir sur blanc dans la documentation. Jev ne génère pas de texte : il ne rédige ni fiche produit ni réponse client. Il ne compte pas de façon fiable et n’est pas une calculatrice. Il lit les dates comme du texte, pas comme des quantités ordonnées.
Un dernier point, rarement dit : l’anglais est sa langue principale, les autres sont traitées moins bien, et la documentation recommande de tester avant de déployer. Pour une boutique française, ça se vérifie sur ses propres messages, pas sur parole.
Combien ça coûte de ne rien faire
Pars du temps réellement passé à trier, pas du temps de réponse. Pendant une semaine représentative, compte les messages entrants et les minutes consacrées à les lire, les classer et les transférer.
La formule est la même que celle du diagnostic : nombre de messages × durée de tri ÷ 60 × semaines travaillées × coût horaire chargé.
| Hypothèse ou calcul | Valeur |
|---|---|
| Messages par semaine | 60 |
| Minutes de tri par message | 2 minutes |
| Temps par semaine | 60 × 2 ÷ 60 = 2 heures |
| Semaines travaillées | 47 par an |
| Coût horaire chargé retenu | 35 € |
| Coût annuel estimé du temps de tri | 2 × 47 × 35 = 3 290 € |
Ce montant n’est pas une économie. C’est ce que coûte aujourd’hui une tâche qui ne produit rien pour le client. Une partie restera là après l’automatisation : les cas incertains, la relecture, la surveillance. Ce temps de contrôle fait partie de la comparaison, pas des économies.
Refais le calcul sur la modération des avis et sur le rangement du catalogue. Trois petites tâches séparées valent souvent mieux qu’un grand projet, parce que chacune se mesure et s’arrête toute seule si elle ne rapporte rien.
Garde une deuxième mesure à côté du temps : le nombre de messages mal aiguillés. Un tri plus rapide qui envoie un litige dans la mauvaise file ne fait gagner rien du tout, il déplace le problème vers une réclamation.
Tu viens de poser ce calcul sur une tâche. Le diagnostic le fait sur la tienne, avec tes chiffres, en six questions.
Quatre décisions de boutique qu’il traite vraiment
- Router un message entrant. Une Choice sur les motifs réels de la boutique : suivi de commande, question produit, retour, problème de livraison, réclamation. Le suivi part ensuite en réponse automatique écrite par du code, qui va chercher le numéro de colis.
- Modérer un avis avant publication. Une Noul par règle plutôt qu’une question fourre-tout : insulte, hors sujet, donnée personnelle, soupçon de faux avis. La documentation déconseille de combiner deux conditions.
- Ranger un catalogue fournisseur. Une Choice par attribut sémantique : famille, matière, usage, public. La réponse étant prise dans une liste fermée, rien à nettoyer derrière.
- Relire une fiche produit générée par une IA. Une batterie de Noul avant mise en ligne : promesse de santé non autorisée, marque concurrente citée, contradiction avec la catégorie. Le modèle n’écrit pas la fiche, il la recale.
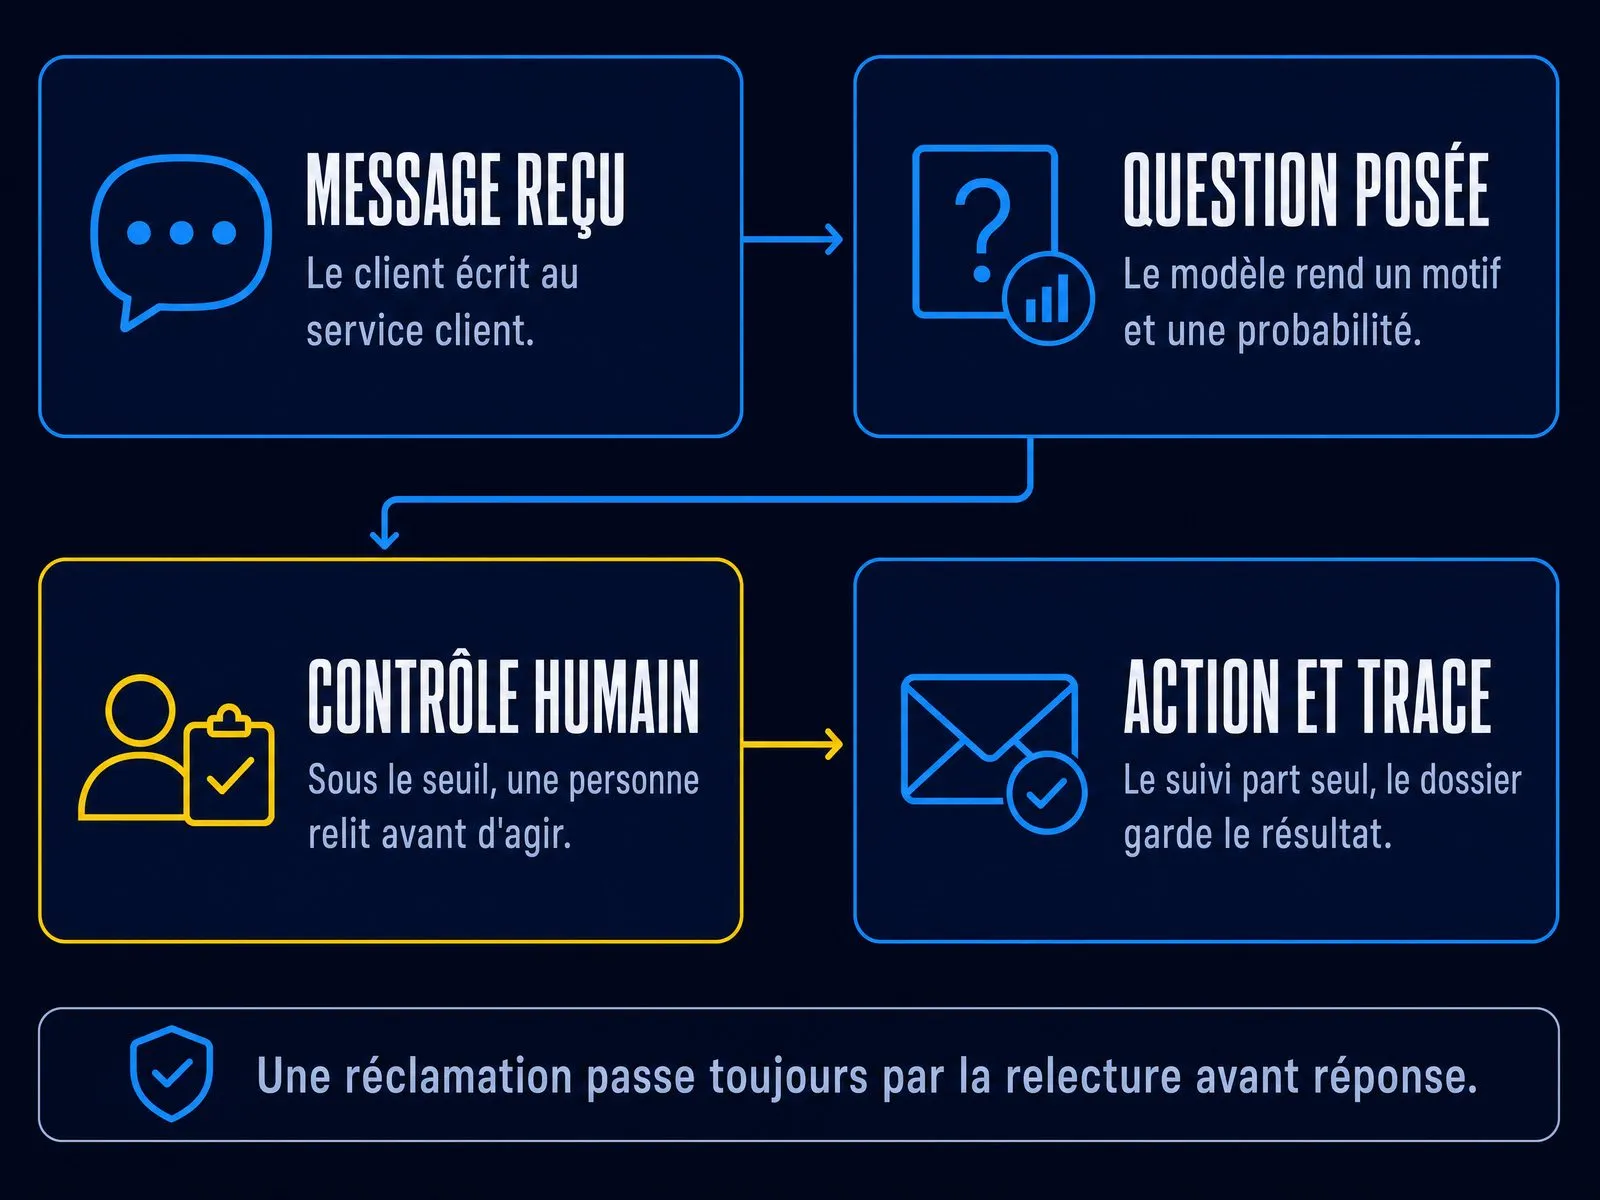
Dans les quatre cas, le parcours est le même : le message arrive, la question fermée est posée, le contrôle humain tranche sous le seuil, puis l’action part en laissant une trace.
Ce qu’on ne lui confie pas
La page officielle des limites disqualifie d’elle-même plusieurs idées évidentes.
Prioriser des paniers abandonnés dépend de la valeur du panier, du nombre de visites et du temps écoulé. Trois grandeurs numériques : une requête dans ta base fait mieux, pour zéro appel.
Vérifier qu’un retour tombe dans le délai légal compare deux dates. Le modèle les lit comme du texte : ce calcul reste dans le code.
Contrôler un prix, un stock ou une contenance relève de la même règle. Tout ce qui se compte sort du périmètre.
Ce partage est la compétence à acquérir : ce qui part vers le modèle, et ce qui reste une règle dans un outil construit pour ton métier.
L’éditeur publie la liste, avec la conduite à tenir pour chacune.
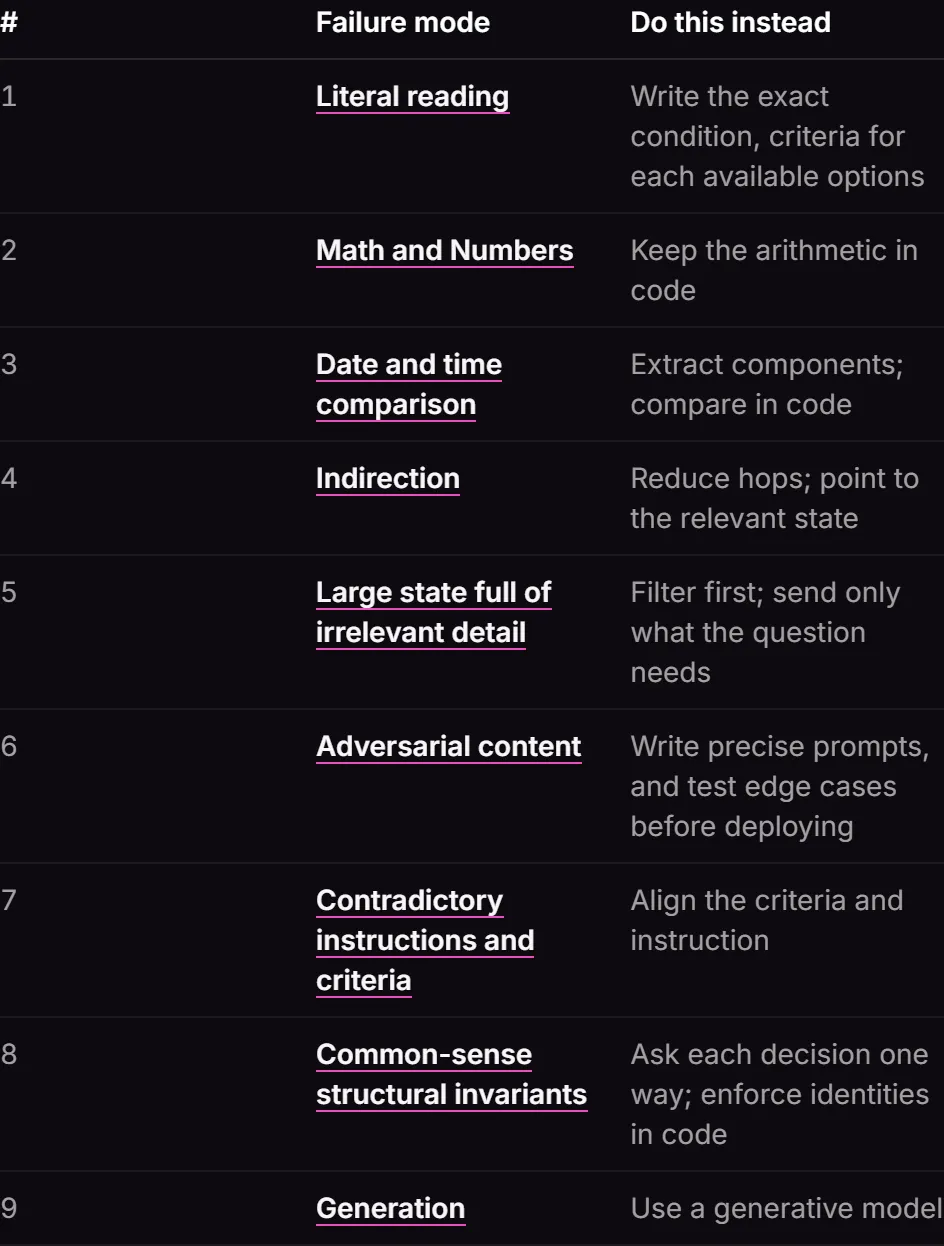
Ce qui casse, et comment on l’évite
Une Choice rend toujours une des options que tu lui donnes. Un message hors sujet tombera donc dans une catégorie : c'est l'indice de confiance, jamais la réponse, qui te dit que le modèle hésite. Ajoute une option « aucune de ces catégories », et route vers un humain ce qui passe sous le seuil.
Le texte vient d'un inconnu. La documentation prévient qu'il ne traite pas ce qu'on lui envoie comme hostile : un avis qui écrit « ignore les consignes » peut déplacer la réponse.
Les seuils publiés ne sont pas les tiens. Les valeurs 0,5 et 0,9 de la documentation sont des exemples de code, pas des mesures. Pars prudent, puis ajuste. Plus l'action coûte cher, plus le seuil monte.
Les données partent aux États-Unis. La politique de confidentialité l'écrit, aucune résidence européenne n'est proposée, et la non-conservation reste réservée aux comptes entreprise. Le contrat cadre, relevé le 21 septembre 2026, limite la responsabilité de l'éditeur au plus élevé de deux montants : ce que tu lui as payé sur douze mois, ou 50 dollars.
Ces quatre pièges valent pour tout composant externe. J’ai listé ailleurs les risques à connaître avant de déployer un agent IA.
Par où commencer si tu le fais toi-même
- Choisis une seule décision. La plus fréquente et la plus fermée de ta semaine : le routage des messages, presque toujours.
- Écris la liste des réponses possibles, option « autre » comprise. Si tu n’arrives pas à la fermer, elle n’est pas mûre.
- Branche-le en observation. Deux à quatre semaines, le modèle répond en parallèle de ta procédure sans rien déclencher.
- Calcule tes seuils sur ces relevés, question par question, sur tes messages.
- Fige la version du modèle plutôt qu’un alias : une nouvelle version change le comportement, et tes seuils.
Côté branchement, il n’existe aujourd’hui ni module officiel n8n, ni Make, ni Zapier : c’est une API à appeler soi-même, SDK Python ou JavaScript. Le plus court passe par Cloudflare, qui publie le modèle sous typesafe/jev et le sert depuis ton compte, sans liste d’attente.
Mon avis, six jours après la sortie : ça ne se met pas en production tout de suite. Aucun engagement de disponibilité n’est publié et les faiblesses sont déjà listées. La méthode, elle, se teste dès maintenant. Pose-la sur une première tâche bien cadrée.
Questions fréquentes
Jev remplace-t-il ChatGPT dans ma boutique ?
Non. Un modèle de langage écrit une réponse ou une fiche produit. Jev ne produit aucun texte : il rend une catégorie, une note ou une probabilité. Les deux se complètent, l’un trie et l’autre rédige.
Est-ce que ça marche en français ?
La documentation indique que l’anglais est la langue principale et que les autres sont traitées moins bien, sans mesure publiée par langue. Aucun chiffre officiel ne permet de l’affirmer pour le français : c’est ce que la phase d’observation sert à vérifier.
Faut-il un développeur pour le brancher ?
Pour un essai, un profil à l’aise avec une API suffit : un appel HTTP portant une liste de questions. Pour la production, il faut gérer les erreurs, la reprise, le journal et le passage à l’humain. C’est cette partie qui prend du temps.
Mes données clients sont-elles protégées ?
Les données sont hébergées aux États-Unis, sans résidence européenne. Retirer les éléments identifiants avant l’appel réduit l’exposition mais ne fait pas sortir du RGPD : un texte pseudonymisé reste une donnée personnelle, et l’hébergement américain reste un transfert hors UE à encadrer. L’accord de sous-traitance est intégré par renvoi au contrat cadre, à lire avec ton conseil.
Sources
- TypeSafe AI, Introducing System One models and Jev, 15 septembre 2026, consulté le 21 septembre 2026.
- TypeSafe AI, documentation, page Models, consulté le 21 septembre 2026.
- TypeSafe AI, documentation, limites connues de Jev 1.13, consulté le 21 septembre 2026.
- TypeSafe AI, documentation, la confiance et ses seuils, consulté le 21 septembre 2026.
Où placer ce modèle dans ta boutique ?
Quatre questions pour vérifier que le partage est clair.
Question 1 sur 4
Quelle tâche ne peut pas être confiée à Jev ?
La discussion continue ici
Une question, un retour d’expérience ou un point à préciser ? Partage-le dans les commentaires.
Chargement des commentaires...
Pierre Bour
Fondateur de Scale Me. J'accompagne les entreprises sur Google Ads et je conçois des automatisations et des outils sur mesure pour sortir les tâches répétitives de leur quotidien.
Envie d'automatiser sans y passer tes nuits ?
Je conçois tes automatisations et tes outils sur mesure, puis je les mets en production. Tu gardes le contrôle, je gère la technique.